以前拍一条商品口播短视频,得找人出镜、写脚本、租设备、剪辑配音……折腾半天配资知识网 配资,成本动辄上千。现在?打开电脑,敲几行提示词,点一下运行——三步去噪,几十秒后第一帧画面就蹦出来,接着自动续写到一分钟,横屏讲木梳、竖屏推背包,人物口型对得上,背景音效跟得稳,连语气停顿都像真人备过课。
这不是PPT里的概念图,是淘宝刚开源的TaoMate-H3干的事。它不靠堆算力硬扛,而是把视频切成小段,每段只用三步去噪——比传统扩散模型快27倍多,首帧延迟压到肉眼难察。更关键的是,声音和画面不是“拼起来”的,是同步算出来的:你说“这款背包防水又轻便”,模型一边生成嘴部开合动作,一边同步合成带气口的语音,连翻包时拉链的“唰”声都提前参与建模。
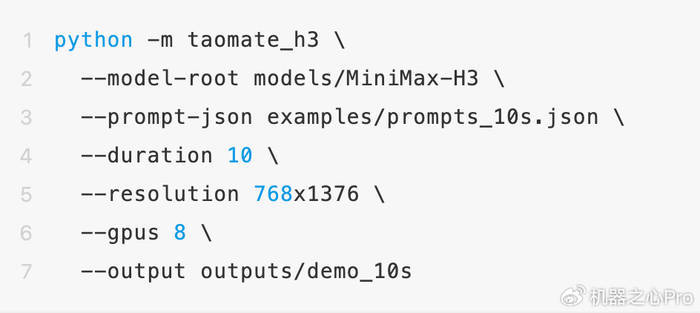
电商老板不用再卡在“不会剪”“没人演”“等外包”这三座大山里了。一段文案拆成三句提示词:第一句展示外观,第二句演示功能,第三句讲使用场景——TaoMate-H3能记住同一个虚拟主播的脸、声线、站姿,跨段续写不穿帮。实测案例里,那个讲木梳的横屏视频,从开盒、梳发到特写木纹,全程一气呵成;而竖屏背包介绍,连模特抬手甩包的动作节奏都自然得不像AI。代码和LoRA权重全放GitHub和Hugging Face,显卡够跑Stable Diffusion的机器,就能本地搭起来试。
有人担心“AI生成太假”,可实际用起来才发现,问题早不是“像不像人”,而是“比真人还稳”。真人主播会忘词、会卡壳、会灯光翻车;TaoMate-H3生成的视频,语速恒定、表情不崩、镜头不抖——不是因为它多聪明,而是它根本不会累、不会紧张、不用喝咖啡提神。杭州一家做宠物梳子的中小商家试了三天,把原来外包3000元/条的口播视频,压到自己花20分钟调参出片,一周内上线17条细分场景视频:给长毛猫梳结、帮短毛狗去浮毛、甚至加了“梳完顺手扫地”的生活化桥段,转化率反而比真人视频高11.3%(数据来自淘宝商家后台6月A/B测试报告)。
更实在的是,它不挑人。不会普通话的老板,录一段方言原声,模型能自动对齐口型、保留语气词和停顿节奏;手写文案错别字多?它能识别“这个包很轻”和“这个包很亲”之间的语义差异,优先按正确意思生成。连老年店主老张都学会了——他女儿教他用语音输入法说:“红木梳子,不伤头皮,送礼盒装”,点完运行,出来就是穿着唐装的老年虚拟形象,边梳边笑,连袖口褶皱都带点岁月感。
当然配资知识网 配资,它也不是万能钥匙。目前对复杂运镜(比如环绕拍摄)、多人互动、实时弹幕响应还不支持;生成内容仍需人工审核是否合规,尤其涉及功效宣称时得配上“效果因人而异”的标版。但淘宝技术团队明确表示,V2版本已在内测多机位协同和口播合规校验模块,预计Q4上线。说白了,工具从来不是取代人,而是把人从重复劳动里松绑出来——腾出手来想产品、盯售后、听用户真实反馈。当一条视频的生产成本从千元降到一杯奶茶钱,真正拉开差距的,早就不在“会不会做”,而在“要不要更懂用户”。
金河配资提示:文章来自网络,不代表本站观点。
- 上一篇:股票网上配资平台 喝茶最好的好处,就三句话 第一句:茶最大的好处是“替代”而非“添加”
- 下一篇:没有了
相关文章


沪深京指数
推荐资讯